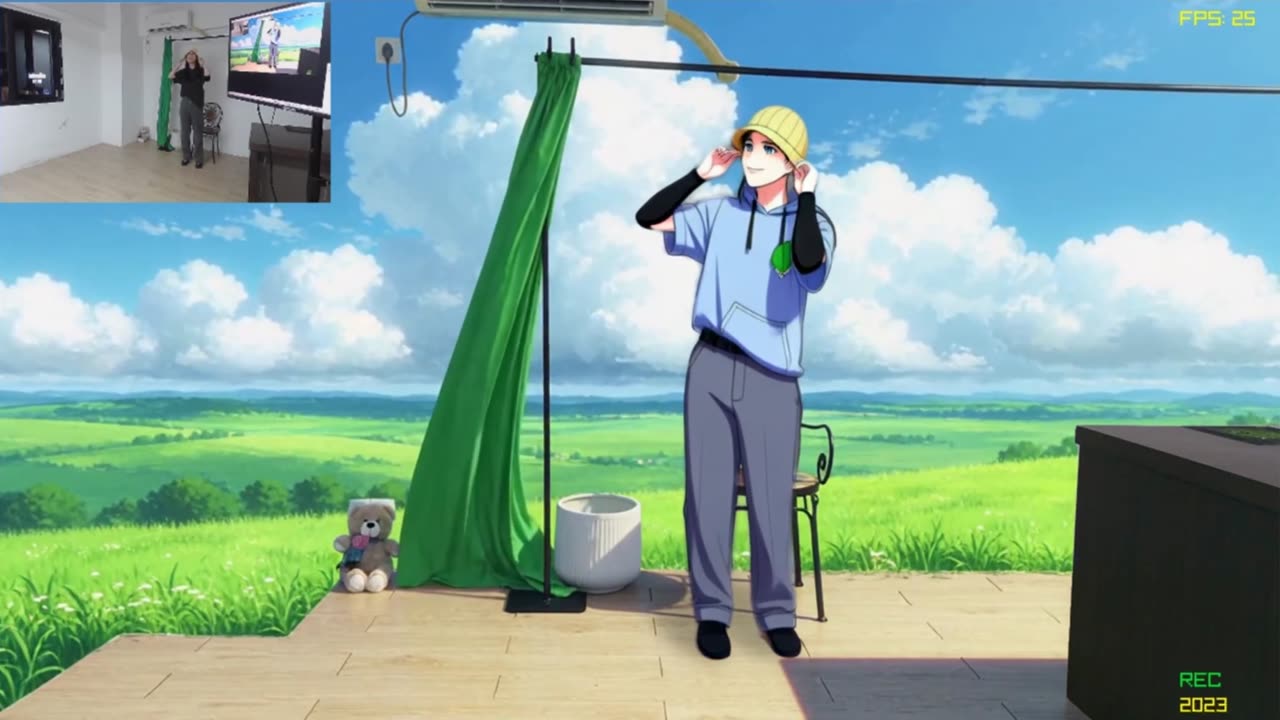
从画面到空间
每一帧先被解析为空间结构:深度、遮挡关系、人物与物体的位置。相机移动时,被遮挡的区域由模型重新推断。
达瓦科技的实时世界模型。从一路摄像头中理解真实空间,按指令改写其中的物体、材质与事件,其余画面保持原样。单张 NVIDIA RTX 显卡实时运行。
点击场景中的椅子、窗帘、花盆或地面
此三维场景由录屏画面与深度估计重建,仅用于演示局部更新;模型实际输出见下方录屏。
同一间办公室,63 秒内连续完成 8 次改写。点击缩略图或输入指令,跳转到对应时刻。
尚未改写
第二段录屏,193 秒。
片段均截自同一段录屏,画面中的中文字幕为录屏原有内容。
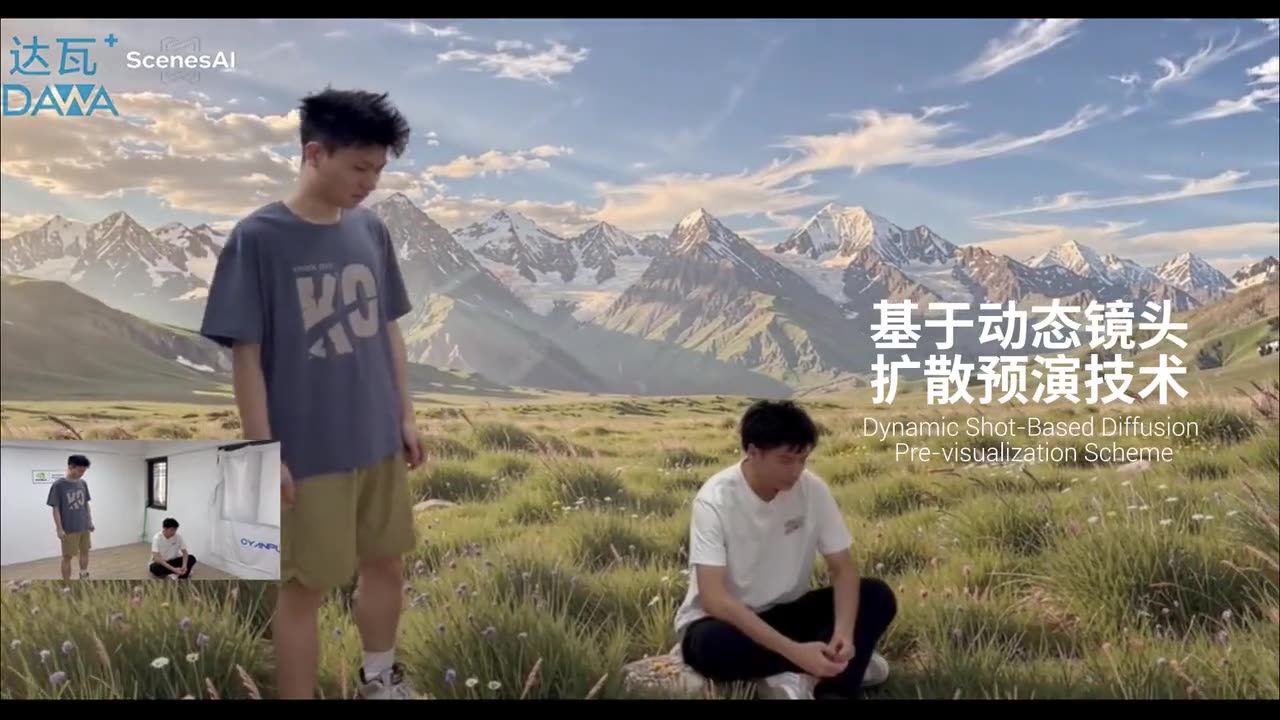
演员在白色影棚中表演,画面实时重建为雪山草原与海滩。动作与机位来自真实拍摄。
墙面重建为木质,窗帘自下而上燃烧,地面铺满花瓣并长出樱花树,其余物体保持原位。
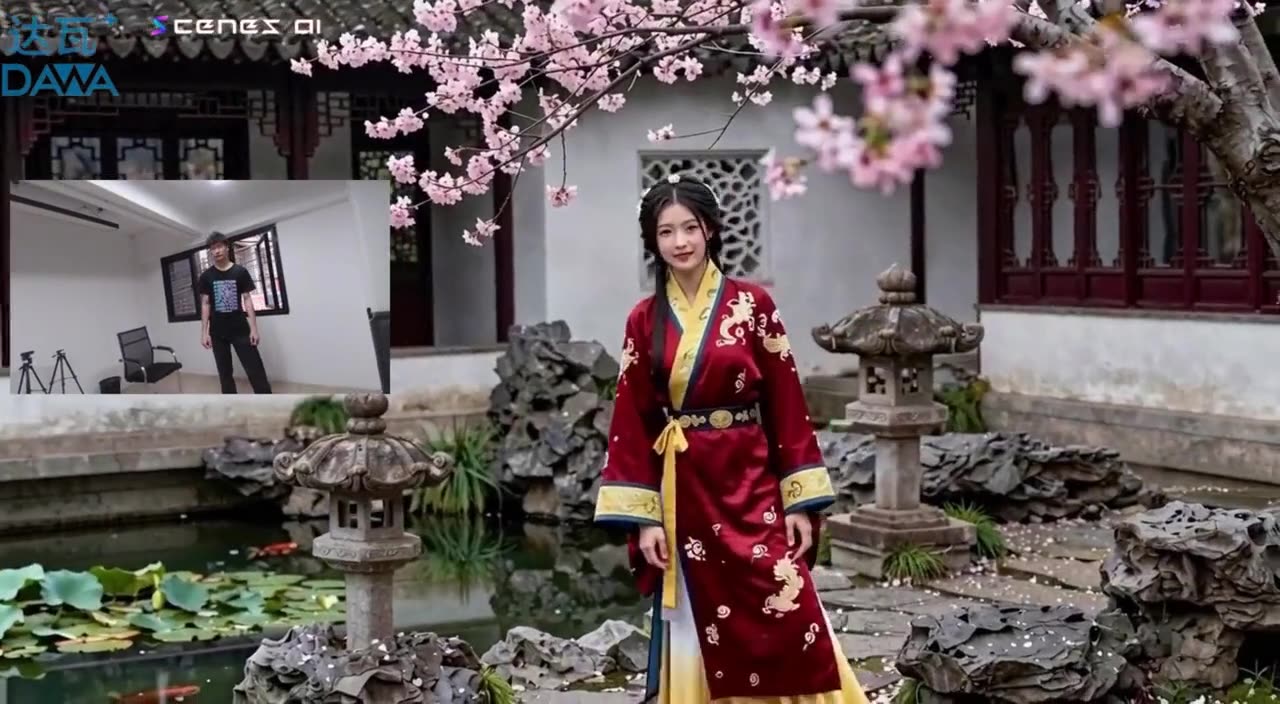
主播在普通办公室中表演,角色、服装与园林场景由模型生成,经 NVIDIA NVENC 编码直接推流。
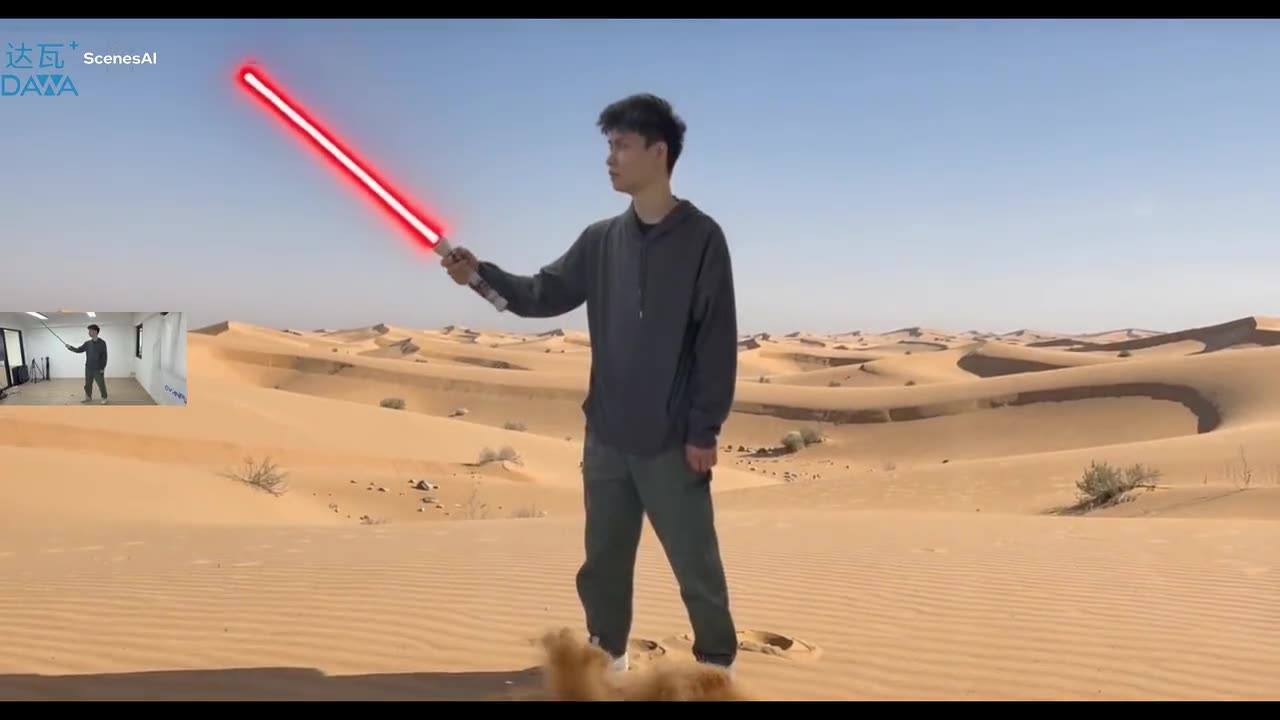
演员手中生成一把随动作挥舞的光剑,仅对局部画面进行扩散,沙漠与人物保持不变。
视频生成每一帧都要重绘整幅画面,稳定的墙面与地面也不例外。ScenesAI 将场景拆解为可独立更新的世界状态,只把发生变化的区域交给生成模型。
拖动中线对比右侧数值由这段录屏相邻两帧的像素差实时计算。
10–20%
典型场景中每帧的变化区域
40–60%
GPU 消耗降低
3–5×
推理速度提升
对比传统视频扩散方案
一次接触事件的处理过程:人物触碰窗帘
世界状态
空间、人物、相机、光照、材质与物理拆分为可独立查询与修改的变量。
Latent Stage
世界构建与精确控制
Live Stage
实时局部生成
底层由神经物理与神经渲染约束运动、碰撞、重力与材质响应,火光与阴影同步作用于环境。系统基于 CUDA、TensorRT 与 NVENC 构建。
“我们每天都在拍真实的电影和短剧,每一次打光、每一次运镜,都在告诉模型这个世界是如何运转的。世界模型的下一场竞争,属于拥有真实世界过程的团队。”
互联网视频只保留最终画面。片场数据同时记录相机运动、演员调度、物体接触以及导演的每一次调整,这些正是实时生成最容易出错的部分。
180TB
结构化世界状态数据
300+
真实商业项目
300+
单场戏标注维度
8.4万㎡
永川全流程数字化科技片场